搜索优化与AI搜索
如何衡量品牌在ChatGPT、Gemini和Perplexity中的可见度:一套可重复的方法

图片:Unsplash
简要回答
衡量AI可见度,可以使用一套固定的泰语、英语和中文提问测试集,按计划定期运行,用简单的标准评分,并记录在同一张表格中。目标是看趋势,而不是追求精确:AI的回答会变化,因此要重复测试,并跟踪相对于竞争对手的变化。
为什么AI可见度需要单独衡量?
传统的排名跟踪无法显示AI助手是否提到或推荐了您的品牌。由于AI助手的回答会因措辞、地点和会话而变化,您需要一种能够接受这种波动、并从中寻找规律的方法。
如何设计提问测试集?
- 分为三组:品类问题、比较与选型问题,以及品牌问题。
- 编写30至40个贴近真实顾客提问方式的问题,包括长问句和短问句。
- 为重要问题准备泰语、英语和中文版本。
- 在部分问题中加入竞争对手名称,观察您被如何比较。
- 在三个月内保持测试集不变,让趋势具有意义。
每月AI可见度测试循环
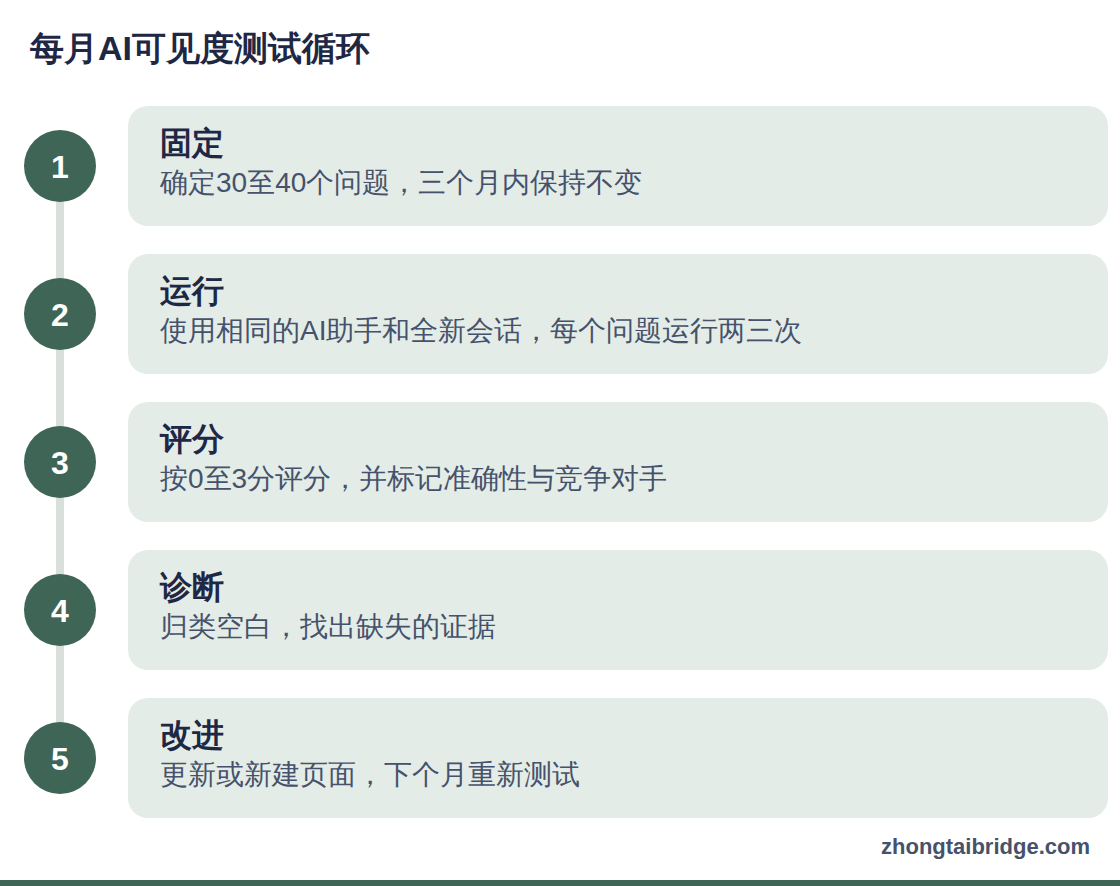
流程图: 1. 固定: 确定30至40个问题,三个月内保持不变. 2. 运行: 使用相同的AI助手和全新会话,每个问题运行两三次. 3. 评分: 按0至3分评分,并标记准确性与竞争对手. 4. 诊断: 归类空白,找出缺失的证据. 5. 改进: 更新或新建页面,下个月重新测试.
如何保持测试的一致性?
- 每月使用相同的AI助手,并记录版本或模式。
- 尽可能使用不带个性化设置的全新会话。
- 每个问题运行两三次,以捕捉回答的波动。
- 记录日期、AI助手、问题、回答和被引用的来源。
- 由两个人分别评分,以减少偏差。
评分标准应该是什么样?
- 0分:未提及品牌。
- 1分:提及品牌,但没有链接或推荐。
- 2分:附链接引用,或作为选项之一被准确描述。
- 3分:被推荐或排在首位,且描述准确。
- 准确性标记:标出任何关于您品牌的错误描述。
- 竞争对手标记:记录出现了哪些竞争对手。
评分标准
| 分数 | 含义 |
|---|---|
| 0 | 未提及品牌 |
| 1 | 提及品牌,但没有链接或推荐 |
| 2 | 附链接引用,或作为选项之一被准确描述 |
| 3 | 被推荐或排在首位,且描述准确 |
如何把结果转化为行动?
- 归类得分为0的问题,找出缺少的页面或证据。
- 查看AI助手引用了哪些来源,以及您能否出现在这些来源中。
- 通过更新页面和各平台资料,纠正错误描述。
- 为空白主题新建或改进页面。
- 调整后重新测试,并记录效果。
如何向管理层汇报?
- 平均可见度得分,以及获得引用的问题占比。
- 随时间变化和按语言划分的趋势。
- 在AI答案中出现最多的竞争对手。
- 已采取和计划采取的行动。
- 业务指标:品牌搜索量和有效咨询。
请说明这些结果只具有方向性,目标是持续改进。
评分表格的结构
- 列:日期、AI助手、语言、问题分组、问题、运行次数、得分、准确性标记、出现的竞争对手、被引用的来源、备注。
- 汇总页:按AI助手和语言统计的平均得分、趋势线以及主要空白。
- 行动记录:空白、假设、内容调整、日期和重新测试结果。
如何解读有波动的结果
单次回答可能差异很大,因此要寻找稳定的规律:某个问题在大多数测试中都出现了您的品牌、某个来源被反复引用,或者某个竞争对手在一组问题中占据主导。如果在发布或更新内容后结果发生变化,请记录日期和改动,但不要仅凭一个数据点就断定存在因果关系。经过几个月,结果与内容行动之间的关联才会更有说服力。
看板字段与计算公式
使用同一张表格,每次提问运行记录一行。列包括:日期、AI助手、语言、问题分组、问题、运行次数、得分、准确性标记、出现的竞争对手、被引用的来源和备注。汇总公式包括:按AI助手和语言统计的平均得分;得分达到2分及以上的问题占比;被引用的来源中属于您的不同来源数量;以及出现频率最高的前五名竞争对手。再建立一份空白清单,列出连续两个月得分为0的问题,并指定负责人和改进计划。每季度汇报趋势,并标注您所做的内容调整,让读者看到两者之间的关系,而不必断言确定的因果。如实对待波动:如果同一问题两次运行的结果不同,两次都要记录。
示例:一家市场进入咨询机构三个月的提问跟踪
以下为示意案例。一家泰国市场进入咨询机构建立了36个问题的测试集:12个品类问题(例如中国企业如何进入泰国市场)、12个选型问题(例如聘请代理机构前应该问什么),以及12个品牌和竞争对手问题。第一个月,该品牌在大多数品类问题上得分为0,主要只在直接输入品牌名时出现。团队发现,AI助手引用的是政府统计页面、少数几家咨询公司和一些科普文章,而没有引用它的任何页面。于是,团队用答案前置的开头、有来源的统计数据和常见问题重写了支柱指南,发布了一个注明来源的统计数据页面,并获得了两次第三方提及。
到第三个月,该品牌在几个品类问题上得到1分或2分,并在两个选型问题中被引用。团队并没有声称是这些改动导致了变化,但记录了改动内容和时间,重复测试并持续维护空白清单。在输出结果充满波动的领域,有用的衡量就是这个样子。
让结果更可靠的抽样方法
- 每个问题使用相同的措辞,并另外准备一组改写版本,用于检验结果的稳健性。
- 尽可能在一天中相近的时间测试,并使用泰国网络或泰国地区设置。
- 记录AI助手的版本或模式,因为其行为会变化。
- 每个问题运行两三次,并记录结果范围。
- 请两位审核者对部分样本评分,检查一致性。
- 保存完整回答,便于日后查看AI助手的原话。
管理层关于AI可见度指标的常见问题
应该测试哪些AI助手?测试您的买家正在使用的。从泰国使用最广泛的通用AI助手开始,再根据需要加入与搜索结合的AI助手。
如何与竞争对手比较?在部分问题中加入竞争对手名称,记录出现了哪些品牌,并跟踪提及份额随时间的变化。
值得付费购买工具吗?请评估其方法、语言覆盖和透明度。第一个季度用人工记录通常就足够了。
什么是合理的目标?先让重点问题从“未提及”变为“被提及”,再变为“被引用”。目标应根据您的基线来设定。
常见问题
需要多少个问题才够?
30至40个精心挑选的问题,就能提供有用的全貌。只有在能够保持一致性时,才增加更多问题。
可以用工具自动完成吗?
有些工具能提供帮助,但请核实其方法。起步阶段,人工记录通常就足够了。


